128K 超长上下文窗口
单次会话支持百页级科研文献与跨模块源码仓库完整输入,长距离逻辑关联精准稳定。
DeepSeek(Deep Seek)即问即答官方智能引擎 · 深度求索未至之境
DeepSeek官网旗下的 DeepSeek-R1 与 DeepSeek-V3 模型依托 Multi-head Latent Attention(MLA)与大规模强化学习训练,在竞赛级数学推演、全栈算法工程、长文档语义解析与多语种创作中实现卓越的性能突破。
无论通过 DeepSeek网页版开展交互式课题攻关,还是依托 DeepSeek api开放平台部署高并发服务,硬盘级上下文缓存均可自动降低高达 90% 的重复前缀推理开销。
| 能力分类 | 评测基准 | DeepSeek-R1 | DeepSeek-V3 | OpenAI o1-1217 | Claude 3.5 Sonnet |
|---|---|---|---|---|---|
| 数学推理 | AIME 2024 (Pass@1) | 79.8% | 39.2% | 79.2% | 16.0% |
| 高阶数学 | MATH-500 (Pass@1) | 97.3% | 90.2% | 96.4% | 78.3% |
| 代码算法 | Codeforces (Percentile) | 96.3% | 58.7% | 96.6% | 20.3% |
| 通用推理 | MMLU-Pro (Exact Match) | 84.0% | 75.9% | 81.6% | 78.0% |
| 中文理解 | C-Eval (Zero-Shot) | 91.8% | 90.1% | 85.4% | 86.8% |
单次会话支持百页级科研文献与跨模块源码仓库完整输入,长距离逻辑关联精准稳定。
DeepSeek api开放平台默认启用 Context Caching,缓存命中输入低至 0.14 元 / 百万 Tokens。
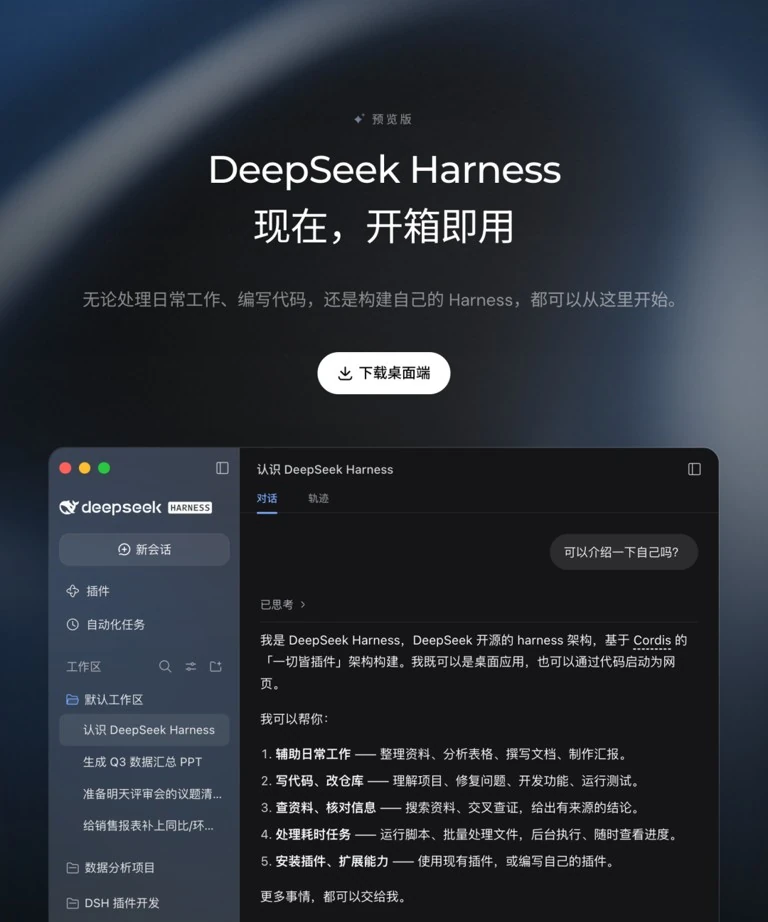
完整开放模型权重与 DeepSeek Harness 评测脚本,全面支持本地私有化算力集群部署。